AI 时代软件手册重构:为人也为 AI Agent
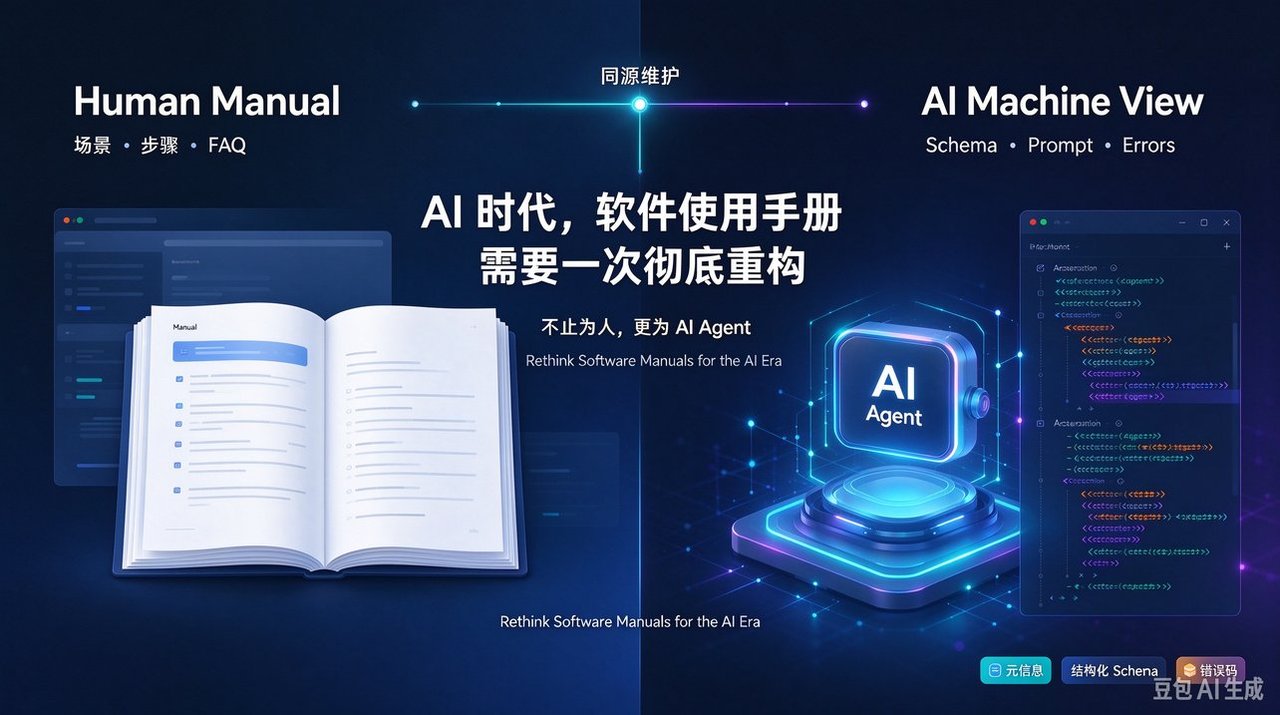
手册不再只是给人看的说明书,更是给 AI 系统读取、解析、调用工具的机器基建规范。
我们一直在谈 AI 赋能、智能自动化、Agent 落地,但绝大多数人忽略了一个最基础、最致命的底层问题:今天 99% 的软件工具手册、产品文档、操作指南,都是「仅为人类设计」的。
传统手册擅长讲故事、讲场景、配截图、做科普,适配人类的学习逻辑;但对 AI Agent、大模型工具调用、自动化工作流而言,这类文档冗余、模糊、无结构、难解析。
结果是一个普遍的行业痛点:企业花大量成本训练 AI、搭建 Agent 工作流,却因为文档不支持 AI 高效读取,出现调用错乱、参数幻觉、执行失败、反复重试,最终拉高 AI 落地成本、压低自动化成功率。
本文交付一套可直接落地的文档重构方案:为什么传统手册完全不适配 AI、人机双轨的新文档架构长什么样、AI 专属手册该写哪六个模块、以及轻量与企业级两种落地方案怎么选。本文不涉及模型微调方法,也不讲某个具体文档工具的教程——它只回答一个问题:如何让工具文档成为 AI 稳定调用的基建。
你将学到三点
- 目标决定内容——传统手册的核心目标是「让人学会用」,AI 手册的核心目标是「让机器稳定、低成本、零幻觉地调用」。目标不同,内容体系必须拆分。
- AI 专属手册是六个模块,不止 Prompt——元信息、结构化 Schema、调用约束 Prompt、Few-Shot 样例、错误码容错、AI 可读变更日志,缺一不可。
- 落地二选一——中小工具、快速验证用「单文档双分区」;核心业务、企业级系统用「双文档分离」(
manual.md+tool-ai-spec.json)。
背景:为什么传统手册完全不适配 AI
很多团队的落地误区是:直接把现成的产品手册、操作文档喂给大模型,指望 AI 能自主学习、正确调用工具。但结果往往是——AI 读得懂、用不好,看似能用、极不稳定。
两者的根本差异在于目标不同:
| 维度 | 传统人文手册 | AI 专属手册 |
|---|---|---|
| 核心目标 | 让人学会用 | 让机器稳定、低成本、零幻觉地调用 |
| 内容取向 | 场景、故事、截图、FAQ | 结构化、标准化、强约束、最小信息集 |
| 优化指标 | 学习体验、上手速度 | 调用成功率、Token 成本、响应延迟 |
人文手册的四项天然属性,恰好与 AI 调用的需求完全相悖:
- 信息冗余,Token 成本极高。 产品介绍、使用背景、操作小贴士、案例故事对人类学习有价值,对 AI 工具调用完全无用。多余文本持续占用上下文窗口,增加推理成本、拉长响应延迟。
- 语言模糊,存在大量歧义与默认常识。 「适量填写」「按规则操作」「特殊情况除外」——人类可以凭经验理解,AI 会直接产生幻觉、边界判断错误,导致调用出错。
- 无结构化定义,机器无法精准解析。 传统手册极少严格定义参数类型、必填项、枚举值、返回结构、错误码、限流规则。没有标准化结构,AI 只能靠模型泛化能力猜测调用规则,容错率极低。
- 只讲「怎么做」,不讲「不能做什么」。 人文手册几乎不会明确标注能力边界、高危操作、禁止行为、参数禁忌——而这恰恰是防止 AI 越权、误用、出错的核心约束。
方案总览:人机双轨文档体系
我们不需要废弃传统人文手册,而是建立「人机双轨」的全新文档架构:一套面向人类用户学习阅读,一套面向 AI 机器解析调用,同源维护、独立读取、各司其职。
- 人文视图(保留原有):服务用户、运维、操作人员,侧重场景讲解、步骤演示、截图案例、FAQ 排错。
- AI 机器视图(全新新增):服务大模型、AI Agent、自动化工作流,侧重结构化、标准化、强约束、最小信息集,优先保障调用效率与性价比。
            同源维护
              │
      ┌───────┴───────┐
      ▼               ▼
  人文视图          AI 机器视图
  manual.md         tool-ai-spec
  ─────────         ─────────────
  场景/步骤/截图     元信息 + Schema
  FAQ/排错          约束 Prompt + 错误码
  面向「学」         面向「调」
三条设计规则,经得起迭代:
- 绝不让两套视图互相污染——AI 视图不塞故事,人文视图不塞参数表。
- Prompt 只是 AI 视图的一个模块,不是全部;把它单独拎出来优化,解决不了 Schema 与错误码缺失的问题。
- 同源维护、独立读取——文档更新时两套视图同步更新,避免新旧规则冲突。
AI 专属手册的六个核心模块
一套完整的 AI 专用工具手册,必须包含六大核心模块,彻底解决 AI 调用的所有不确定性。
1. 工具元信息(AI 识别基础)
作为 AI 读取文档的头部信息,用于模型快速识别工具定位、成本与状态,避免无效调用:
- 工具唯一标识、版本号、更新时间、废弃标记
- 能力摘要:一句话明确工具「能做什么」
- 能力边界:明确工具「不能做什么」(防幻觉核心)
- 调用成本、限流规则、最大并发、超时时间
2. 结构化 Schema 定义(精准调用核心)
用机器可解析的标准化结构替代模糊的文字描述,杜绝参数猜测,对标 OpenAPI 规范:
- 输入参数:名称、数据类型、必填/可选、枚举约束、格式要求、取值范围
- 返回参数:字段定义、数据类型、默认值、空值规则
- 批量调用限制:数据条数上限、文件尺寸约束
{
  "tool_id": "export-report",
  "version": "2.1.0",
  "cannot_do": ["不支持导出超过 30 天的历史数据"],
  "input": {
    "format": { "type": "enum", "values": ["csv", "xlsx"], "required": true },
    "rows":   { "type": "int", "min": 1, "max": 50000, "default": 1000 }
  },
  "errors": { "E429": "retry_after_60s", "E403": "abort_and_report" }
}
这段示例想说明的是:参数类型、枚举值、边界、错误码全部是声明式的,AI 读到的是规则而不是需要推理的散文——数据格式对错从此由 Schema 保证,而非靠模型猜。
3. AI 专属调用约束 Prompt(行为规则核心)
Schema 解决「数据格式对错」,专属 Prompt 解决「AI 行为逻辑对错」,定义 AI 调用工具的所有行为准则,无需人工反复调教模型。核心包含四类规则:
- 调用前置校验规则:参数非空校验、枚举匹配、权限校验逻辑
- 禁止行为规则:禁止批量超限、禁止越权调用、禁止自定义参数
- 失败处理规则:不同错误码的重试策略、终止策略、上报策略
- 结果输出规则:返回数据的整理格式、禁止编造信息、精简要求
4. 极简 Few-Shot 样例(快速对齐调用逻辑)
摒弃冗长的人类操作案例,仅保留高保真、极简的「输入–输出」样例,用最少 Token 帮助 AI 快速对齐标准调用逻辑,降低理解偏差。
5. 完整错误码与容错策略
单独梳理机器可读的错误码体系,明确每一类报错的成因与 AI 自动化处理方案,解决 AI 调用失败后盲目重试、卡死流程的问题。
6. AI 可读版本变更日志
标记参数新增、废弃、规则变更内容,让 AI Agent 可自动适配工具版本迭代,避免新旧规则冲突导致的批量调用失败。
两种落地方案:按迭代节奏选
| 方案 | 做法 | 优势 | 不足 | 适合 |
|---|---|---|---|---|
| 单文档双分区 | 现有 Markdown 手册中新增独立「AI 参考区块」,人类读全文,AI 只读专属区块 | 改造成本低、维护成本低、无需拆分文档 | 结构化能力有限,复杂工具的 Schema 定义不够严谨 | 中小工具、快速落地验证 |
| 双文档分离 | manual.md 面向人类;tool-ai-spec.json 面向 AI,含 Schema、Prompt、错误策略、样例 |
机器解析效率最高、零冗余、稳定性最强,可直接对接 Agent 框架与自动化工作流 | 初次改造成本稍高,需要建立规范维护机制 | 核心业务工具、企业级系统 |
决策规则:先用单文档双分区验证价值,工具进入核心链路后再升级为双文档分离。
效果与收益:赢在效率与性价比
很多团队误以为「优化文档是小事,优化模型才是大事」,但在实际落地中,文档标准化带来的收益,远高于小规模模型微调(就我们观察到的落地案例而言,效果因团队与工具复杂度而异)。重构 AI 专属手册,能直接解决三大核心问题:
- 大幅降低 AI 运行成本——极简的机器可读文档剔除无效冗余信息,减少上下文 Token 消耗,降低推理成本与响应延迟,长期累计性价比极高。
- 彻底降低幻觉与调用失败率——结构化 Schema + 强约束 Prompt + 明确边界规则,从源头限制 AI 自由发挥,杜绝参数编造、越权调用、逻辑错误,让工具调用从「猜测式」变成「确定性」。
- 实现 AI 工作流的可维护、可迭代——工具版本迭代同步更新 AI 规范文档,无需反复微调模型、重写 Prompt,让 Agent 能力随工具迭代平滑升级。
反对意见与适用边界:主张「先优化模型、文档以后再说」的团队,在模型能力持续提升的语境下短期或许成立;但只要工具仍在迭代、Agent 仍在批量调用,文档不结构化带来的调用失败与重试成本就会持续累积——这也是为什么两种落地方案都保留了「不足」一栏:轻量方案结构化不够严谨,企业级方案初期改造成本更高,按阶段取舍即可,不存在一步到位的免费方案。
总结
- 目标不同,内容必分——手册从「赋能人」转向「赋能 AI 自动化」,人文视图与 AI 机器视图必须双轨并行。
- 六个模块缺一不可——元信息、Schema、约束 Prompt、Few-Shot、错误码、变更日志,Prompt 只是其中之一。
- 先选对落地节奏——轻量用单文档双分区,企业级用双文档分离,先验证价值再升级标准。
在 AI 智能化转型的早期阶段,真正拉开团队差距的,往往不是模型选型、算法能力,而是标准化、机器可读的基础基建。尽早完成 AI 专属手册重构,就是为 AI Agent 落地搭建最稳固、最高性价比的底层基建——不妨先从你手头最核心的一个工具开始,把它的「AI 参考区块」写出来。
如果你在工具文档 AI 化的过程中踩过坑,欢迎在评论区交流;本站在 知识库 还有更多 AI Agent 落地实践。