子智能体的速度与安全博弈:四个 AI 编程平台架构对比
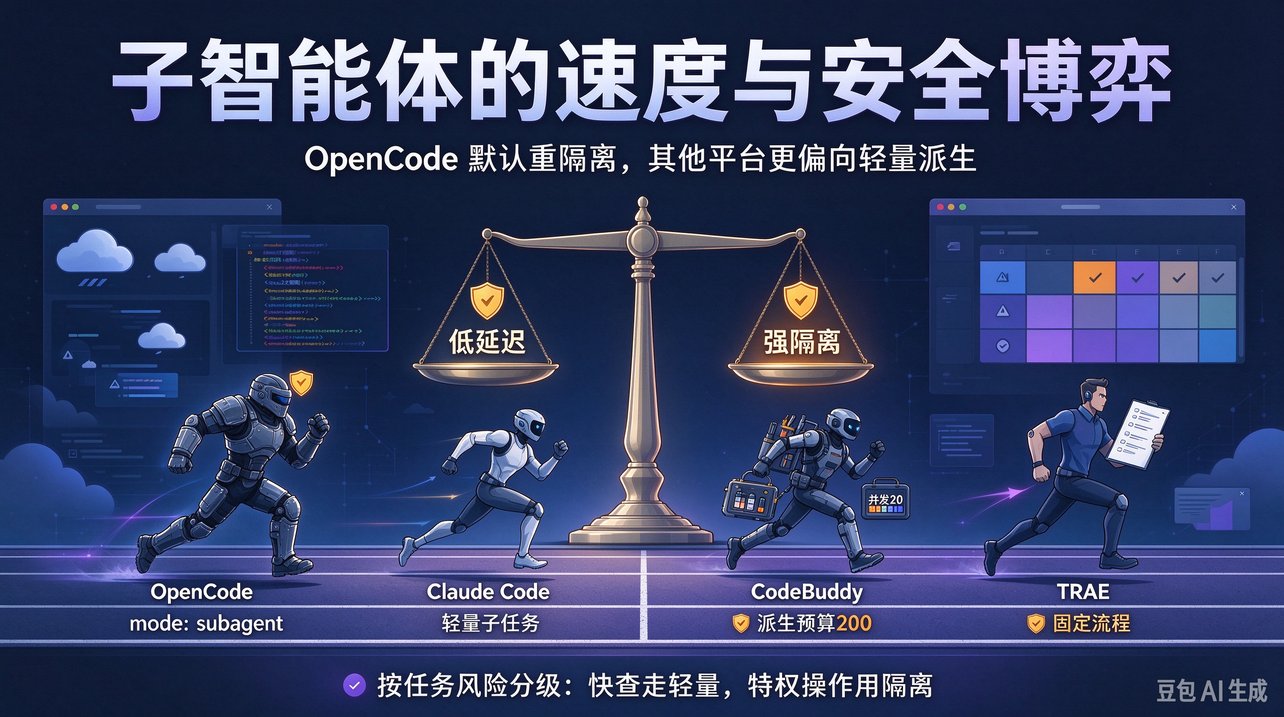
引子
我的日常开发流程里有一条硬规矩:每个任务在 merge 和 push 之前,都得先过一遍本地子智能体的代码审查。跑得多了就发现,同样是一次代码审查委派,OpenCode 跑完的总时间明显比 Claude Code、CodeBuddy 和 TRAE 长。
我没做过计时对比,也说不清差距具体出在哪一步。于是把四家的官方文档摊开逐条比对,想搞清楚子智能体的运行时到底有什么不一样。比出来的结果指向同一个关键分歧:子智能体是跑在一个全新会话里,还是跑在主会话的一个上下文窗口里。
这不是 bug,而是各家文档里明确定义的架构差异。
范围声明
本文只比较官方文档明确定义的行为,不做基准测试,也不涉及价格与总拥有成本对比。文中出现的「更快」「更慢」均指从文档定义推导出的结构性开销,不是实测数字。
一个反常识的事实
你可能以为是 OpenCode 慢、别人快。但翻开文档会发现,四家都承认子智能体本身是「有延迟」的——只是程度不同。
Claude Code 文档在选型建议里写着:
Latency matters. A subagent that isn’t a fork starts fresh and may need time to gather context.
CodeBuddy 文档的「Performance Considerations」一节更直白:
Latency: Sub-agents start from a clean state each invocation and may add latency as they gather context needed to work effectively.
「每次调用都从干净状态重新起步」这个设计,四家都在用,也都被官方写成了成本。OpenCode 只是在这条路上走得更远了一点。
四家的运行时定义
OpenCode:默认重隔离
mode: subagent 的智能体只在子会话中运行,通过 subagent 工具调用,子会话带全新上下文。
权限模型完全独立——自定义子智能体用自己的 permissions 规则,不是父智能体权限的子集。父智能体还需要显式的 subagent 权限才能启动它。
V2 内置可见的 subagent 模式智能体只有 general 和 explore 两个(官方文档明确写了 V2 没有内置的 scout)。其中 general 默认被拒绝再启动子智能体,explore 只保留 read、glob、grep、webfetch、websearch 这几个动作。
Claude Code:同一会话内的独立上下文
子智能体在单一会话内工作,通过 Agent 工具调用。文档说得很清楚:每个子智能体跑在自己的上下文窗口里,但它没有另起一个会话。
权限默认继承父对话(”Each inherits the parent conversation’s permission rules”),可以用 permissionMode 覆盖;完全仓库副本隔离是 opt-in 的 isolation: worktree。
启动负担上它做了不少官方瘦身:内置 Explore 与 Plan 默认不加载 CLAUDE.md 文件和 git 状态快照。这里有个容易踩的坑——omitClaudeMd 只能关掉 CLAUDE.md,关不掉 git 快照,文档明写 “You can’t change which subagents receive git status. Only Explore and Plan skip it.”
CodeBuddy:轻量上下文 + 显式配额
自己的上下文窗口,通过 Agent 工具派生。内置 Explore、general-purpose、Plan,其中 Explore 的出厂模型声明是 lite 档。
配额是四家里写得最细的:嵌套深度上限 5 层,默认 20 并发,单会话派生预算 200 次。MCP 默认延迟加载,模型先经 ToolSearch 发现工具,再用 DeferExecuteTool 调用。
需要注意 tools 字段省略时会继承主线程全部工具(含全部 MCP 工具)——想要真正的最小权限,必须显式写白名单。
TRAE:声明式配置
通过 Markdown 文件定义,运行于独立上下文窗口,中间推理不污染主对话。
两个限制值得注意:只有内置智能体「Agent」可调用 Subagent,编排自由度最低;model 字段只支持 TRAE 提供的内置模型,不支持自定义模型。
横向对照
| 维度 | OpenCode | Claude Code | CodeBuddy | TRAE |
|---|---|---|---|---|
| 运行时模型 | 独立子会话 | 主会话内的独立上下文窗口 | 独立上下文窗口 | 独立上下文窗口 |
| 权限模型 | 完全独立,非父级子集 | 继承父对话,可覆盖 | 省略则继承全部工具 | 仅工具白名单 |
| 嵌套限制 | general 默认不能再启动 |
默认 3 层 | 上限 5 层 | 未单列 |
| 并发 / 预算 | 未单列 | 默认 20 并发 | 20 并发 / 200 次派生 | 未单列 |
| 强制轻量路径 | subagent: false |
默认即轻量 | 内置轻量 Explore |
无 |
表中「未单列」表示该平台文档没有为此单列条目,不代表它没有这个能力——本文只写文档明确写了的。
OpenCode 的 subagent 三态
命令 frontmatter 的 subagent 字段是三态的:
| 值 | 行为 |
|---|---|
true |
一定起子会话,即使所选智能体是 mode: primary |
false |
一定留在当前会话,即使所选智能体是 mode: subagent |
| 省略 | 所选智能体是 mode: subagent 时才起子会话 |
这意味着 subagent: true 与 subagent: false 之间,隔着的正是一次完整的子会话创建开销——后台不等于更轻。后台解决的只是「不阻塞父会话」。
配置示例:
{
  "agents": {
    "orchestrator": {
      "permissions": [
        { "action": "subagent", "resource": "*", "effect": "deny" },
        { "action": "subagent", "resource": "general", "effect": "allow" }
      ]
    },
    "auditor": {
      "mode": "subagent",
      "permissions": [{ "action": "edit", "resource": "*", "effect": "deny" }]
    }
  }
}
权限规则是有序匹配、最后命中者胜出,所以「宽规则在前、例外在后」的写法可读且可预测。
落地建议
答案不是二选一,而是按任务风险分级:
- 快查类任务(简单 grep、摘要、轻量分析):用 OpenCode 命令 frontmatter 的
subagent: false,跳过子会话创建,直接在当前会话跑。 - 特权或高风险操作(不可信仓库检查、风险文件操作、需要独立审计轨迹):用默认的
mode: subagent,老老实实付这份隔离成本。
几条有文档依据的提速杠杆:按智能体裁剪工具池(MCP 工具本身就占用上下文);探索类任务单独派小模型;能用内置轻量智能体就别自己写;需要重复背景的任务考虑 Claude Code 的 fork 模式(它能复用父会话的 prompt cache)。
总结
- 差异来自架构定义,不是实现缺陷。OpenCode 默认每次派生都起全新子会话、用自己的权限规则;Claude Code 把子智能体放在同一会话的独立上下文窗口里,权限继承父级;CodeBuddy 与 TRAE 也是独立上下文窗口,但各自给了更细的上下文与工具瘦身开关。
- 四家都承认「每次重新起步」有延迟成本,OpenCode 只是默认走的是重隔离那条路。唯一被官方明确写为「比全新子智能体更便宜」的路径是 Claude Code 的 fork。
- 混合是更优解。把子任务分成「快查」和「重活」两类分别选执行模式,往往比整体迁移平台更划算。