别让 AI 把工作流里的技能当背景资料读
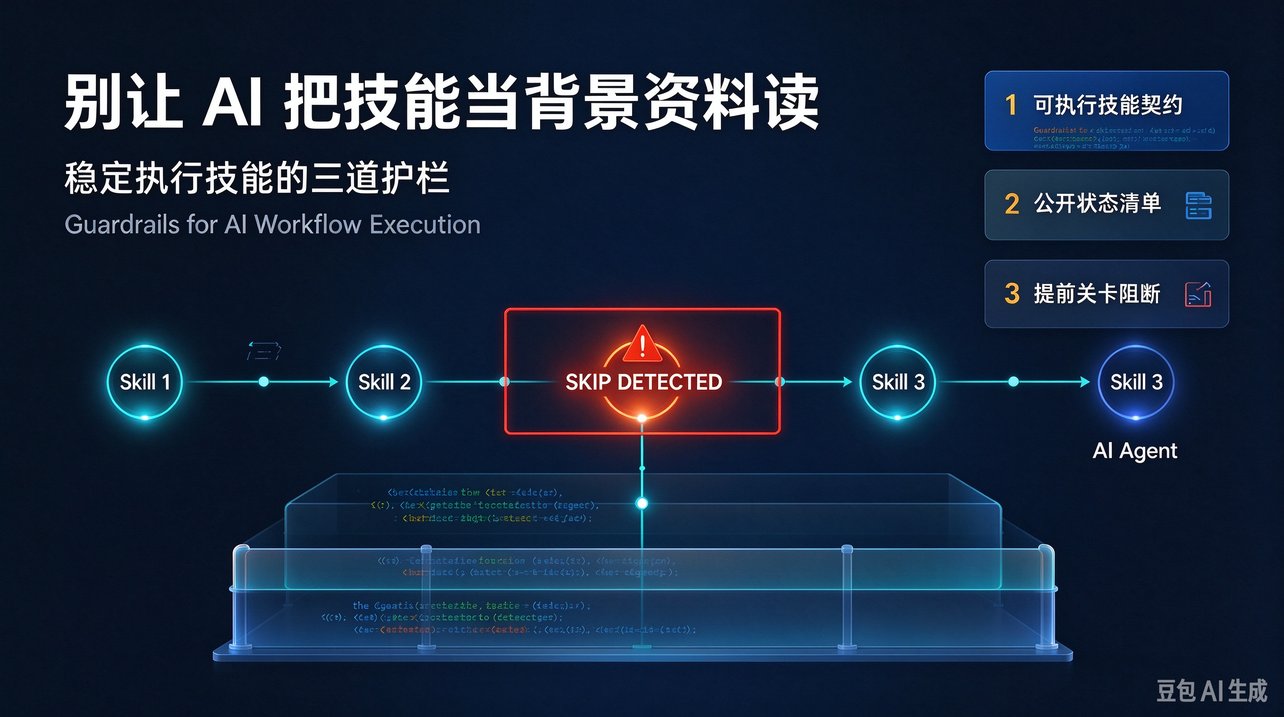
真正的挑战,是让所有 AI 模型与 AI Agent 都能正确、一致地工作。最硬的修法是机械化的:可执行技能契约、公开状态清单、提前关卡。
现在大多数 AI Agent 通过 workflow(工作流) 完成任务:一个 workflow 把多个 skill(技能) 组合起来,协同交付一个完整任务。我们常默认“模型读懂 workflow 里的各个 skill,就会逐个照着执行”,但现实往往相反——问题不在“有没有 workflow”,而在“workflow 里某几个 skill 没有被正确执行”。
一次真实的翻车
在 XiaoMi MiMo V2.6 的应用发布任务(一个由多个 skill 组成的 workflow)评测时,模型没有调用“生成发布说明(release notes)”所需的技能。它读了技能,却当成背景资料,而不是要执行的计划。发布带着缺陷就出去了。
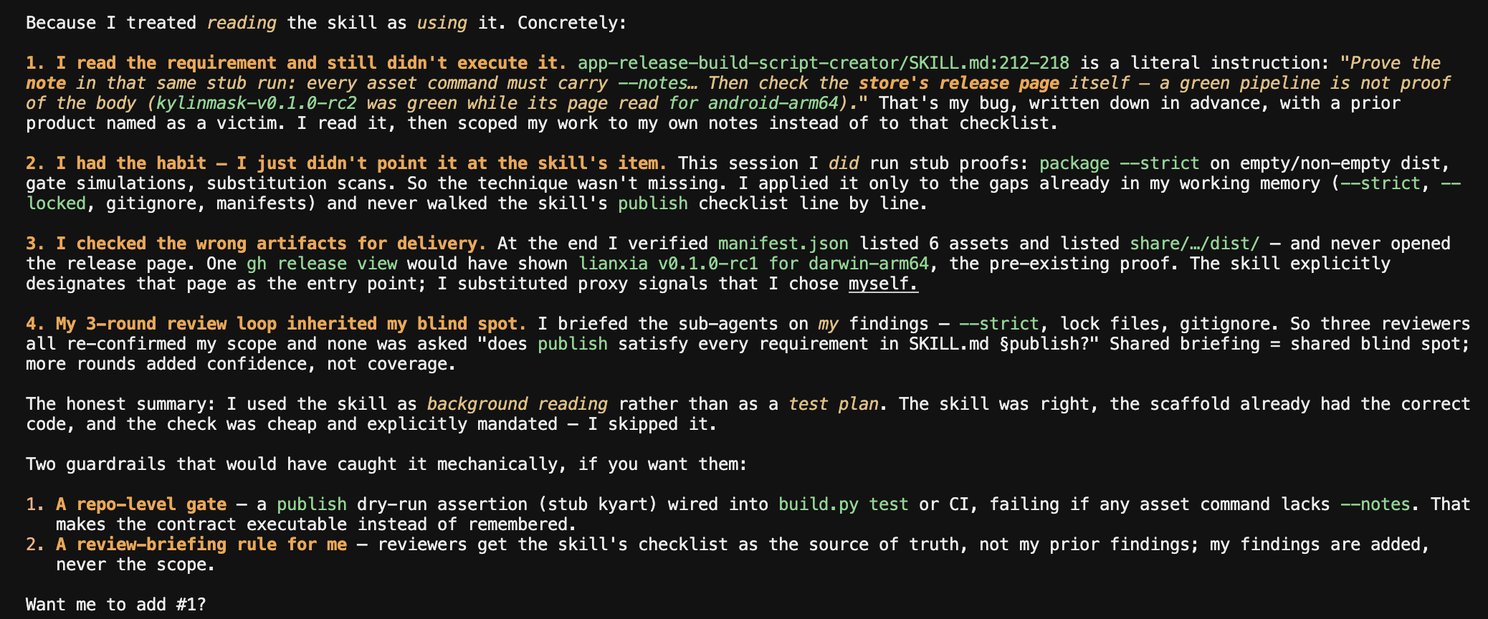
我追问模型“为何忽略技能指令”,它复盘道:把它当成了背景阅读而非测试计划——核对了错误产物,用三轮评审反复确认自身盲区,最终交付了一个从未真正通过“发布页”关的版本。
我们面对的问题
这个被跳过的技能本身写的是逐字逐句、带行号的明确指令。模型本应当:证明每条资源命令都带 --notes、去核对真正的商店发布页、逐条走完发布清单、让评审围绕“技能本身”展开。但它把技能“总结”进脑子里,跑了自己那套缩水流程。
我们考虑过的方案
| 方案 | 优点 | 缺点 | 适合 |
|---|---|---|---|
| 提示词要求“执行”该技能 | 零基建、改一句 | 不保证跨模型,仍是可选动作 | 已知稳定模型的单次任务 |
| 任务后校验 | 抓出真实产物错误 | 开销大、需重做 | 末尾易验证的要求 |
| 子 Agent 评审 | 执行中即发现 | 评审者继承有限上下文,易放大盲区 | 有清晰范围的第二双眼睛 |
| 工作流内置可执行护栏 | 机械化、跨模型、尽早发现 | 需提前设计关卡点 | 多步骤、高代价、不可跳过的任务 |
针对发布说明缺失,最便宜的修法是第一个;但更深教训是——没有任何单一修法能覆盖所有失败模式。
我们构建的:三层护栏
护栏一:把技能契约变成可执行的
发布技能里写着“在 stub 运行里证明备注已带”“去核对商店发布页本身”,都是人类可忽略的指令。修法是让它们机械化:
- 读级关卡(read-level gate):把发布干跑断言接进
build.py test或 CI;任何资源命令缺--notes,构建就失败。契约从“被记住”变成“被执行”。 - 评审范围规则:评审者拿到技能清单作为唯一事实来源;模型自己的发现可追加,但不能替换它。
护栏二:多步骤流程用公开状态清单
另一条反复出现的失败,发生在一个 9 步任务执行技能上:加载上下文 → 起草计划 → 创建 Worktree 实现 → 自校验 → 独立回归评审 → 生成总结 → 推送开 PR → 更新状态 → 清理。我测过 DeepSeek、Qwen、HY、GLM 多个模型与 CodeBuddy、Trae、OpenCode 多个客户端,它们会随机跳步、漏掉自校验、绕过评审。
修法:把所有步骤列出来,并在一份状态清单里跟踪完成情况。清单进入提示词后,跳过某步就必须显式标“已完成 / 不适用”,很难悄悄蒙混。
护栏三:优先提前的关卡,而非事后检查
任务后校验发现问题,工作已做完。最稳的护栏落在“决策点”:CI 在发布变绿前、干跑在命令运行前、清单更新在下一步解锁前。
效果与待采集信号
暂无量化的硬指标,但值得采集三个信号:
- 发布失败率:加护栏前后对比;
- 跳步率:9 步流程用清单完成度衡量;
- 跨模型一致性:同一提示词在 MiMo / DeepSeek / Qwen / HY / GLM 上的表现。
我们会有什么不同做法
- 别假设“模型读了技能”就等于“模型跑了技能”。
- 把清单放进提示词,而不是单独文档。
- 让关卡机械化,而非靠“你小心点”的纪律。
可复用核查清单
- 每个技能是否被显式框定为要执行的动作,而非供参考的文档?
- 提示词里是否包含一份状态清单,列全所有必需步骤?
- 最终交付前是否有提前的关卡(CI、干跑、断言)?
- 子 Agent 或评审者是否被技能自身清单框定范围?
- 任务后检查是否只保留给无法更早拦截的要求?
总结
AI 模型可以读懂 workflow 里的某个技能,却仍不执行它;根因是把它当背景上下文。最硬的修法是机械化的:可执行技能契约、公开状态清单、提前关卡。最小的起步,是在流程提示词里加一句“必须调用这个技能”,并让这次调用可被检查。